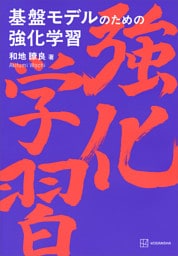
基盤モデルのための強化学習
購入済み


シリーズ
全1冊
作品情報
【推薦の言葉】基盤モデルの性能を引き上げるうえで、強化学習は中核的な役割を担っている。本書は、強化学習の基礎から、基盤モデルの事後学習を支える理論と手法、推論時スケーリング、Agentic RLまでを体系的に解説した、世界的にも類書の少ない一冊である。なぜ強化学習が必要なのか、その可能性と限界を、理論と実例の両面から明快に示す。AIの今後を見通すうえで、本書は重要な羅針盤となるだろう。――岡野原大輔(Preferred Networks代表取締役社長)【本書のポイント】◆基盤モデルを賢くする強化学習、その理論を体系的に理解する!◆いま強化学習は、基盤モデルの振る舞いを制御するための汎用的な枠組みとなっている。各手法がなぜ必要になったのか、どのような仮定のもとで何を最適化しているのか。本書では、これらを数式と直感の両方から解説する。【サポートサイト】https://akifumi-wachi-4.github.io/website/rl4fm【主な内容】第1章 はじめに第2章 強化学習の基礎第3章 基盤モデルを改良するための強化学習問題第4章 強化学習による人間の主観的な選好への適合第5章 強化学習による客観的な正解をともなうリーズニング能力の改善第6章 主観的かつ客観的に良いLLMを獲得するには第7章 言語から他のモダリティへ第8章 推論時スケーリングと強化学習の関連性第9章 Agentic RL第10章 今後の課題付録A 数学的な基礎付録B 強化学習の補足付録C 基盤モデルの基礎付録D 定理3.2の証明
- 著者
- 出版社 講談社
- ジャンル
- レーベル KS情報科学専門書
- シリーズ 基盤モデルのための強化学習
- 電子版配信開始日 2026/10/28
- ファイルサイズ - MB
作品をシェアする
同じ作者の本
-
基盤モデルのための強化学習
¥3,080
購入済み
講談社のおすすめ本
-
週刊少年マガジン 2026年48号[2026年10月28日発売]
¥400
購入済み
-
たいやきデカ (1)だいふくどろぼうを つかまえろ
¥1,540
購入済み
-
発達障害の子の親子でできる運動あそび 柳沢運動プログラムを活用して
¥1,760
購入済み
-
【電子版だけの特典カット付き】晴こころ 1st写真集 晴れのち、こころ ミスマガジン2025ミスヤングマガジン
¥3,500
購入済み
-
基盤モデルのための強化学習
¥3,080
購入済み
-
はじめてのずかん てんき
¥2,420
購入済み
-
異次元緩和 経済敗戦と背徳者たち
¥3,520
購入済み
-
ダウン症がわかる本
¥1,980
購入済み
-
山本里菜1stフォトブック「りな、です」【デジタル限定カット付き】
¥2,970
購入済み
-
ベストカー 2026年11月26日号【2021年9月26日号合体版】
¥650
購入済み
スマホ・PC・ITのおすすめ本
-
基盤モデルのための強化学習
¥3,080
購入済み
-
研鑽 コンパイラ
¥3,740
購入済み
-
3時間で身につく Genspark 活用術
¥2,178
購入済み
-
Androidスマートフォン迷わず使える操作ガイド2027(超初心者向け/幅広い機種に対応)
¥1,249
購入済み
-
3行で深掘り! 仕事で使えるAI単語帳
¥2,200
購入済み
-
仕事で役立つ!PDF完全マニュアル[第3版]
¥1,980
購入済み
-
Visual Studio Code 2026 パーフェクトマスター
¥3,465
購入済み
-
WHOWATCH magazine Sweets 2026
¥1,320
購入済み
-
イラストで学ぶ 自然言語処理 大規模言語モデルへの最短コース
¥3,300
購入済み
-
本気で稼ぎたい出店者のためのYahoo!ショッピング販売攻略法
¥1,980
購入済み